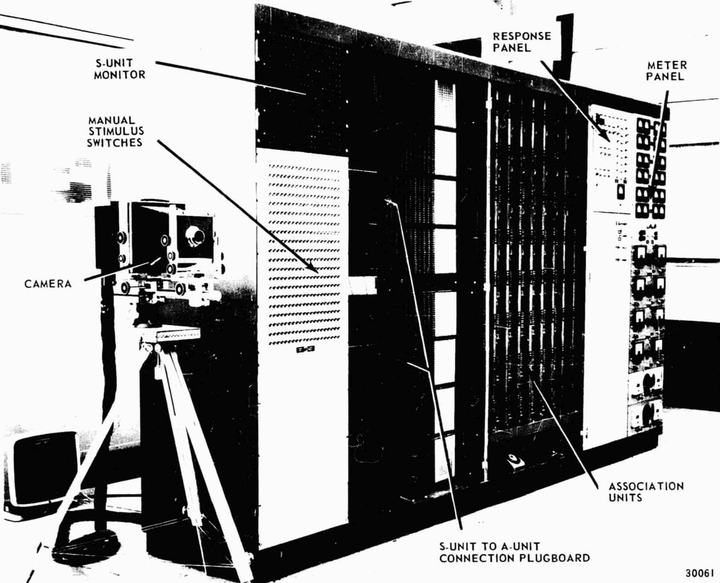
1980年代末,两张照片并排摆着看,很有意思。一张在东边:东京,第五代计算机计划的展览厅,国家级的红地毯。另一张在西边:MIT实验室的走廊尽头,一个小摊位上堆着信封和卡片——有几个人在教机器认字。不是印刷体,是手写的、各种歪法都有的那种数字。
东边那一桌是当年的主桌。西边这一摊,登记在本子上属于“边缘”。七年后,主桌撤了。再过二十年,世界坐到了小桌子那边。
崩盘先从设备开始。专家系统跑在专用的Lisp机器上,价格是个人电脑的十几倍。可1987年前后,通用工作站追了上来:别看它不会推理,它便宜、快,还能同时记账。专用机器像宠物一样娇贵,通用机器像牲口一样好养——预算委员会投了牲口的票。
接着是商业模式。知识工程的维护账本摊开一看,大家都懂了:这不是软件,这是手工定制家具。行业风向一年内转完,人工智能公司成批关门,第二次冬天到场。它和第一次冬天的区别大概是:第一次是诚实的失败,第二次是成功的疲惫。
行业里的标准寒暄也回来了,只是换了词:“神经网络?那不是1969年就证明不行了吗?”——你看,一本书的读法,可以比这本书本身长寿二十年。
而被留在冬夜里的旋钮,就在这时被重新拧动了。1986年,《自然》杂志登出一篇论文,作者是三人:鲁梅尔哈特、辛顿、威廉姆斯。论文解决的是一个具体到不能再具体的技术问题——多层网络里的“中间层”怎么学习?
先把问题说明白。一层旋钮的网络,学错了好办:哪个旋钮把答案带偏了,就拧哪个。两层、三层堆起来之后,麻烦来了:错的只有出口那一层,中间那层谁该负责?看不到,算不出,像是被告藏在一堵墙后面。
他们的办法叫“反向传播”。说白了:从出口的错误开始,往回一层一层分摊责任,每个旋钮都收到一张小纸条——“这次错了,你有多少份”。然后每个旋钮朝反方向微调一点点。下次再错再摊。分摊与微调,循环往复。
想象一支球队输了球。教练没法让每个人重踢一遍,但他能复盘:把丢球的责任,按每个环节往前倒推,分给后卫、中场、守门员。每个人下次各退半步、各进一步——球队慢慢变成能赢的球队。旋钮不是在“被编程”,它们是在被复盘。
复盘的数学名字,是链式法则——复合函数的求导规则,大学一年级的内容。全套办法压缩起来,就是……算了,我的编辑一直说,每出现一个公式,读者就少一半。前六章我一个都没舍得用。下面是全书唯一的一次挥霍:注 · 谁先发现“谁发明了反向传播”至今是笔糊涂账:1970年芬兰人林纳因马、1974年美国人沃博斯都独立写过这件事。科学史上“第一”很少是单数——更多时候,是一个想法在地板下等了很多年,等的不是发现者,而是一双正合适的鞋。
看懂了吗?没看懂也完全没关系。只需要带走一句话:错误成了说明书。这台机器最反直觉的地方在于——它不需要有人教它,只需要有人告诉它“错了”,剩下的交给那本退回来的、用错误写成的说明书。
这只眼睛的家谱,要往前翻二十多年。1959年,两位神经科学家在麻醉的猫头后部插进电极,放幻灯给猫看:漆黑的屏幕上,一个光点它不理,一条斜着的亮线,它的神经元却立刻炸响。他们越试越细:有的细胞只对竖线发火,有的只认横线;没有人教过猫什么是竖——是大脑的第一层,自己长成了一排边缘探测器。这两位半路出家的医生后来拿了诺贝尔奖;而更远的回响,要到几十年后才被人听出来:认东西这件事,居然是从认线条开始的。
1980年,一位日本研究者福岛邦彦把这排探测器做成了程序:一层认线条,往上一层认线条的组合,再往上一层认组合的组合——他给它起名叫“新认知机”。名字起得很老派,思路却很超前:识别不需要一个大而全的天才,只需要一层一层,把简单的问题堆成复杂的问题。它缺的只有一样东西:一种足够好的自学方法——那件东西,1986年就位。
把反向传播用出成绩的是法国人杨·勒昆。他在巴黎学完,又跑到多伦多的辛顿门下做了博士后——把这个师承记住,后面的故事里,这几个人会像一支地下乐队:各自散了,又总在同一个台上。1989年,他在贝尔实验室造出一只“会滑动的眼睛”:卷积网络。原理值得当场翻译:与其让每个位置的每个像素都配一套旋钮,不如做一枚小印章——划线、拐角、圆弧,各刻一枚——让它滑遍整张图,到处盖印。一张图上的同一个特征,不管出现在左上角还是右下角,识别的都是同一枚印章。旋钮的数量因此一落千丈,学起来快得多。
你认字,靠的不是把“8”在视野里每个位置重新学一遍;你学的是一笔弧线。这台机器也一样。
学成的眼睛很快去上班了:读信封上的邮编,读支票上的金额。到1990年代末,据估计,全美银行业和邮政系统里,每十张支票就有一张由它过目。这可能是“深度学习”第一次大规模上岗——只是当时它还没有这个名字,也没有人注意。
与“会读的手艺”同时上岗的,还有“会听的手艺”。九十年代,医院和律所的听写室里悄悄换上了语音识别——它用的是统计派的正统工具,没挂“智能”的招牌,所以也没被冬天冻着。同一门学问的两条腿,就这样一前一后走出了雪地:一条在台面上挨冻,一条在账本里长大。
同一时期还有一张安静的桌子,在IBM。一位叫泰索罗的研究者让一台程序玩双陆棋——没有棋谱,没有大师指点,就让它自己跟自己下:赢了,把刚才路上的判断记深一点;输了,记浅一点。一百五十万盘之后,它的棋风开始让顶尖高手皱眉——1990年代中期,它已经能和世界级棋手互有胜负。这盘棋最深的一课埋在细节里:那些“路上”的判断,是拿后来的输赢反推出来的——和反向传播的“复盘”,是同一种脑回路。凭对弈学会棋,棋谱一页都不用翻开——二十多年后,这句话会在另一副棋盘上变成头条。
这份成绩没能保住它的座位。1996年,勒昆离开贝尔实验室,去了NEC——不是跳槽,是潮水在退:实验室的母公司拆分之后,“不直接赚钱的研究”几个字越来越需要辩护。他带着那套“印章”,从黄金年代最贵的一张桌子上,搬到了另一个安静的地方。论文被引用了上万次;当时的招聘市场上,这份履历的常见批注是四个字:方向不明。
1998年,他和同伴把这些年的手艺整理成一份完整的图纸:印章、滑窗、层层相叠、反向传播,一样不缺。后来的人给这份图纸补了个名字:LeNet。图纸是完备的,零件是齐的,只缺一样——一个装得下它的舞台。它在抽屉里躺了十四年;十四年后被拿出来时,图纸一行没改:变的只有舞台。
既然能行,为什么没能一鼓作气?因为缺两样东西,而他们两样都缺。
第一样是例子。要让几十层旋钮学会画画,需要的不是几百张三寸照片,是几百万张、几千万张带标签的图。1990年代的数据世界是没有的。第二样是力气。反向传播一趟,要算几十亿次乘法;当时的电脑跑一遍要几个星期,辛顿们等不起。
三个名字里,辛顿的冬天最具体。这个英国人当年去剑桥读的是实验心理学——他想弄明白脑子是怎么工作的;心理学系给不了他要的那种答案,他转身扎进了人工智能。他的博士在爱丁堡:1972年入学,做的正是神经网络。注意年份和地点——莱特希尔的报告刚把那个系拆过一遍,系里劝他换个“有前途”的方向。他换了说法,没换方向:论文做到1978年才交付,题目是《松弛法及其在视觉中的作用》。一个人的冬天,比行业的冬天早来了五年。
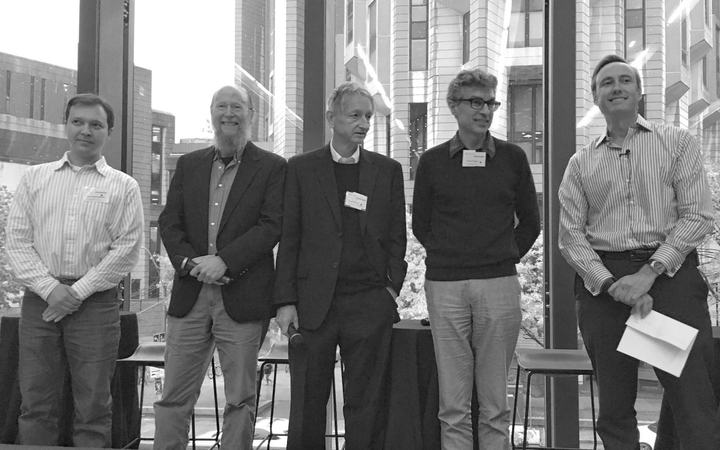
于是旋钮被搁回架子上。整个1990年代到2000年代初,风头属于另一套工具——支持向量机,数学更优雅,理论上限更清楚,不需要那么多例子。神经网络的会议越开越小,论文越来越难发。有几个名字几乎全凭固执留在牌桌上:辛顿在多伦多,勒昆在新泽西,本吉奥在蒙特利尔。他们申请经费时反复听到同一句评语:“这是在死路上开车。”后来人们把这三人叫“深度学习三巨头”——不是因为他们赢了,是因为当时只剩他们还开着。
不过这张桌前不只有冷风。辛顿早就搬去了加拿大——1980年代末,他因为不愿拿美国军方的钱,把家安在了多伦多;多年后回头看,这一步像替这个行业提前存下了一笔火种。2004年,加拿大的一家资助机构批准了一个听起来很小众的项目:专门养神经网络,把散在各校、平时申不到钱的这批人,编进了同一份名单。经费不多,但稳定;更值钱的是那串名字——辛顿、本吉奥,以及他们共同的学生。定期的会,加上可以一起分摊的算力采购,三张孤立的桌子,渐渐围成了半间屋子。行业的冬天靠个人取暖;而个人的冬天,靠有人提前把柴搬进屋。
统计派凭什么占上风?凭一种旧世界的硬通货:证明。他们的工具带着完整的数学行李——误差有上界,边界有定理,白纸黑字地告诉评审委员会:“最坏的情况,也不会比这更坏。”而神经网络交上来的答卷写着:效果很好,原理不详。在对“说不清”零容忍的那个年代,这份成绩单输得不冤——冬天里,理论就是取暖费。
三个人各自守着自己那张桌子。本吉奥在蒙特利尔一边带学生,一边做一件当时没人看得懂的事:让机器学“词”——把每个词换成一串数字,意思相近的词,数字就相近。这项工作的论文发表于2003年,引用量要到十年后才开始爆炸;当时没有人知道,未来那座大模型的第一块地板,就是这么不声不响铺下去的。2006年,辛顿给这条搁置已久的路线起了个新名字:深度学习。名字起得讲究——“神经网络”四个字在经费委员会的账本上已经透支了;换上一件没有前科的外套,年轻人愿意重新排队进来说:我想做这个。一门外语换一次运气,这个行当里,换名字有时真的有用。
新名字下面还压着一件真东西。同一年,辛顿团队交出一套“逐层预训练”的手艺:先让第一层学最粗的花纹,学会就冻住;再让第二层在第一层的成果上学花纹的组合;一层一层往上码——像盖一座难盖的楼,先把每层的模具都浇结实。深网络第一次显出了“能训练”的样子。《科学》杂志把其中一篇论文放上了版面:科学界最矜持的公告栏,为一个旧念头开了门。这不是胜利,只是呼吸——而冬天里的人,最先恢复的就是呼吸。
他们缺的例子和力气,其实正在别处孵化:一边是互联网——人类正把自己的照片、购物、聊天记录、整个世界,一张一张传上去;另一边是显卡——本来为电子游戏设计,正悄悄把“算几十亿次乘法”变成一种便宜的娱乐。
死路上的车,就要等到它的燃料了。